
内容概览
本文围绕“微软发布 MAI Code1.1Flash 模型,GitHub Copilot 将支持本地与云端混合推理”整理核心信息、适用场景与使用条件,便于读者快速了解重点,再决定是否进一步体验或查阅项目资料。
详细信息
微软于2026年10月7日的 Windows 和 Surface 发布会上宣布,将于本月底前为 GitHub Copilot 引入本地 AI 模型支持,允许开发者在云端与设备端模型之间自由切换或实现自动调度。
针对端侧推理中的内存瓶颈与长上下文资源占用问题,微软推出了高效的 MAI Code1.1Flash 混合专家(MoE)模型。该模型拥有1370亿总参数及68亿激活参数,结合量化与投机解码技术,在显著降低内存占用的同时提升了设备端编码响应速度,并率先搭载于配备 NVIDIA RTX Spark 硬件的新款 Surface Laptop Ultra。
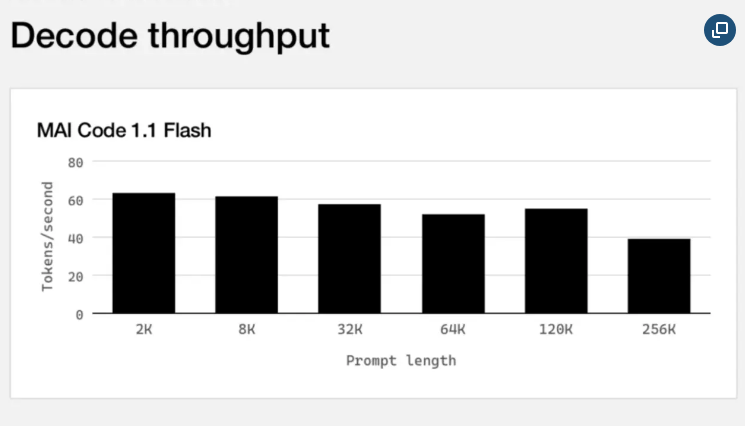
在具体应用上,用户可通过 GitHub Copilot CLI、Copilot 应用及 Visual Studio Code 自主选择推理模式,既可依赖 Copilot 后台自动协调资源,也可指定通过 Windows ML 供应商或兼容 OpenAI 的本地端点调用 MAI Code1.1Flash 等本地模型。安全性方面,系统集成了 Windows 团队构建的微软执行容器(MXC),利用各操作系统原生的容器隔离机制保障代码运行安全。
此次升级标志着 AI 编码助手正加速从纯云端依赖向“云端+端侧”协同的混合架构演进。这一举措不仅简化了本地模型的部署门槛,也为高隐私、低延迟的开发场景提供了更高效的落地方案。
编辑整理:阅读要点
- 功能和价格可能随版本或地区变化,使用前应查看最新说明。
- 安装软件或启用服务时,优先使用项目官方渠道并检查所需权限。
- 是否适合长期使用,应结合自身设备、工作流和实际体验判断。
延伸阅读
资料来源:news.aibase.com。本文依据公开资料整理,不是独立采访或独家报道。