
内容概览
本文围绕“Anthropic发布Claude Opus5.5:任务成本降40%、输出提速30%,9项测试7项领先GPT-6Astra”整理核心信息、适用场景与使用条件,便于读者快速了解重点,再决定是否进一步体验或查阅项目资料。
详细信息
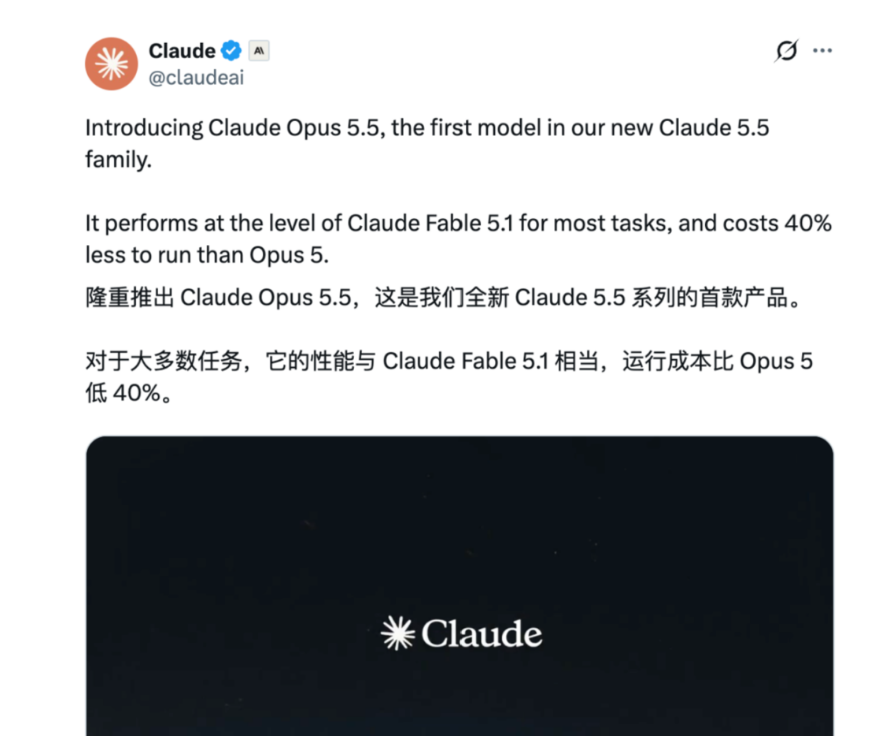
Anthropic于9月23日凌晨发布Claude5.5系列首款模型Opus5.5,官方称多数任务表现与Fable5.1相当,默认设置下典型任务成本较上代Opus5降低40%,输出速度提升超30%,已上线Claude及亚马逊云科技、谷歌云、微软Azure。
官方公布的9项测试中,Opus5.5有7项领先Fable5.1、Opus5及OpenAI的GPT-6Astra、GPT-5.6Sol。三项编程测试均取得最高分:Terminal-Bench4.0达66.4%,FrontierCode v1.1为54.4%,CursorBench4.0为57.8%,但业务流程与科研Agent测试落后于GPT-6Astra。Artificial Analysis Intelligence榜单上,其以58分位列第一,领先Fable5.1与GPT-6Astra的53分。
长任务表现是升级重点:内部测试中,Opus5.5用9.5小时完成负载均衡软件HAProxy从C语言到Rust的改写,成本较Fable5.1低51%;在需逐一核对数字与引语的财报研究测试中,其18份报告有16份达标,Fable5.1与Opus5均未通过;有早期测试者不到一天完成涉及68万行代码的迁移。
价格方面,每百万输入、输出Token收费4美元和20美元,较Opus5降20%,缓存读取降60%;Pro、Max等套餐五小时使用额度同步提高,订阅用户另获一次限额重置机会。
安全上,Opus5.5尝试绕过隔离边界的频率较Opus5降低约85%且自行报告相关行为,提示词注入防御与Fable5.1并列受测模型最低成功率;但大多数网络安全任务仍会转交Opus4.8,官方承认部署前评估无法发现所有失效情况。
发布近2小时后,OpenAI即推出GPT-6Sol与Luna;Sonnet5.5与Haiku5.5计划未来几周上线。以效率与成本压缩换取Agent规模化落地,正在成为头部模型竞争的主线。
编辑整理:阅读要点
- 功能和价格可能随版本或地区变化,使用前应查看最新说明。
- 安装软件或启用服务时,优先使用项目官方渠道并检查所需权限。
- 是否适合长期使用,应结合自身设备、工作流和实际体验判断。