
内容概览
本文围绕“开源图像生成迎来新突破:OpenMOSS发布MOSS-Image,主打长文本渲染与可编辑布局”整理核心信息、适用场景与使用条件,便于读者快速了解重点,再决定是否进一步体验或查阅项目资料。
详细信息
近日,OpenMOSS(复旦NLP与上海创智等团队)正式发布了开源图像生成模型 —— MOSS-Image。针对传统文生图模型在海报、信息图、漫画及UI设计中常年面临的“文字拼写错误、段落截断、元素错位”等痛点,该模型以5B参数的单流 DiT(Diffusion Transformer)为基座从零开始预训练,全面支持最长约4K token的提示词、中英文长文本渲染以及可编辑的结构化 JSON Layout。
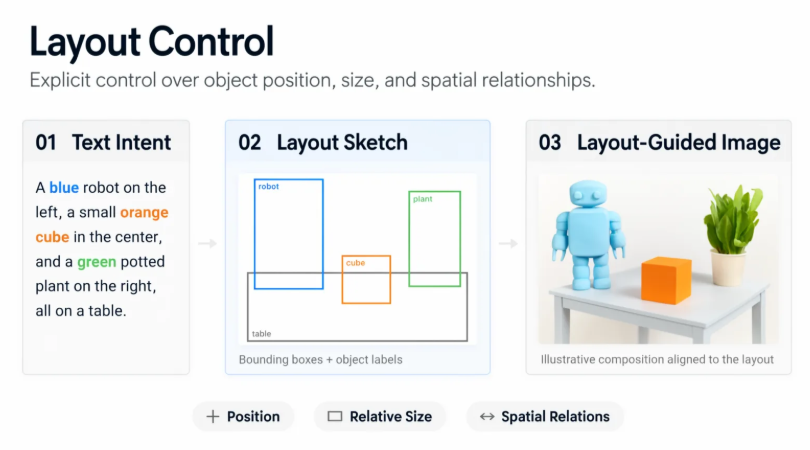
在技术架构方面,MOSS-Image采用Muon–AdamW训练配方,通过统一的文本条件通道来处理自然语言和结构化布局。模型使用 Qwen3.5-9B 作为文本编码器,并配合 FLUX.2VAE 进行图像解码。训练数据集涵盖约3B张图像,融入了多粒度caption、文字监督与结构化边界框(bbox)监督。为了应对复杂创作需求,模型还引入了意图感知的提示增强(PE)外部规划模块,可将简短的请求自动扩展为包含字体层级、色板和坐标规范的可执行指令。
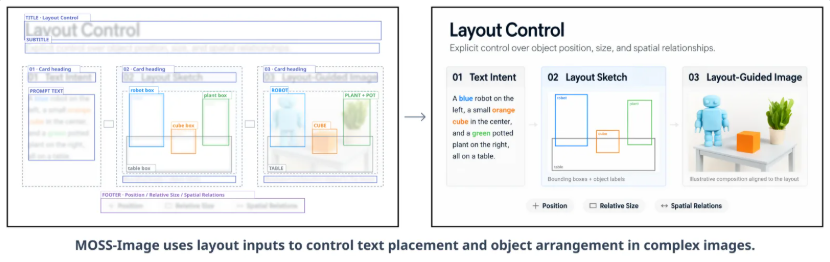
在核心能力与评测表现上,MOSS-Image展现出了极强的专项优势:
长文本渲染(LLTB):在包含中英文各120个任务、平均目标文本约1339.8个字符的评测中,其Mean-6得分为96.3,创造了开源权重模型的新高,能够较好地保留换行和段落结构。
结构化布局(7Bench):在统一JSON Layout任务上,其检测框mIoU达到0.8786,整体布局mIoU为0.6788,在空间关系和相对大小控制上表现优异。
端到端偏好(RealLayoutArena):在盲测Elo排名中,其生成器本身在统一增强提示词下的得分达到1807.34,处于行业领先地位。
目前,MOSS-Image 的 Base 与 SFT 权重均采用 Apache-2.0协议开源,并全面打通了 Diffusers、Gradio 和 ComfyUI 等生态路径,支持 LoRA 与全量微调。不过,官方也明确了其当前边界:其 backbone 属于纯文生图模型,无法直接接收参考图或执行原生图像编辑,其提示增强模块也依赖外部语言模型。总体而言,该模型的推出为需要本地部署、精准排版和可复现版式的开发者提供了一个功能强大的开源新选择。
编辑整理:阅读要点
- 功能和价格可能随版本或地区变化,使用前应查看最新说明。
- 安装软件或启用服务时,优先使用项目官方渠道并检查所需权限。
- 是否适合长期使用,应结合自身设备、工作流和实际体验判断。
延伸阅读
资料来源:news.aibase.com。本文依据公开资料整理,不是独立采访或独家报道。