
内容概览
本文围绕“专为端到端大模型打造:新芯航途发布X7 Ultra智驾芯片,中国首发量产Armv9 车规级CPU”整理核心信息、适用场景与使用条件,便于读者快速了解重点,再决定是否进一步体验或查阅项目资料。
详细信息
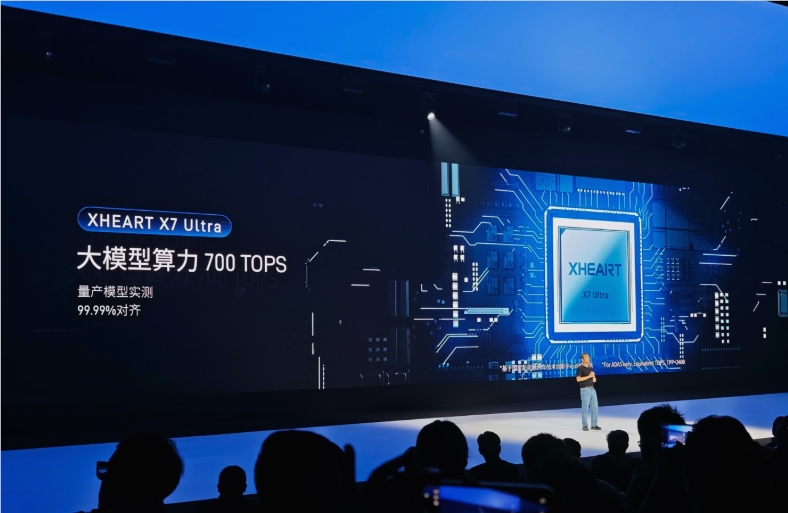
10月29日,XHEART新芯航途正式发布了全新一代智驾大模型芯片——X7Ultra。面对智能驾驶从传统多个小模型向“端到端大模型”演进的行业趋势,新芯航途秉持“大模型定义芯片”的核心理念,在创业之初便决定从真实量产模型的底层需求出发,倒推并重新设计芯片的计算架构、存储方案及数据流转方式,同时为未来模型的持续演进预留了充足空间。
在核心算力与架构设计方面,X7Ultra的大模型算力达到了700TOPS,量产模型的实测对齐度高达99.99%。该芯片专为大模型打造,采用了超大核 NPU 架构,核内数据交互相比传统的核间交互实现了 TB/s 量级的速率提升。同时,其多级缓存架构兼具大容量与高并发特性,能够有效降低推理过程中的时延与功耗。
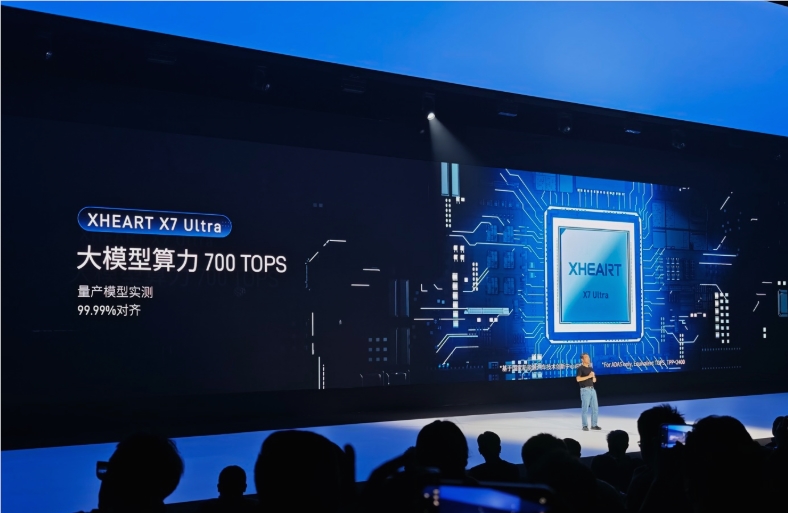
为了确保模型精度与运行效率,X7Ultra内置了高精度大模型专用算子加速引擎,针对 Layernorm、Softmax、Transpose 等一系列 Transformer 大模型关键算子进行了极致的硬件级优化,并原生支持 FP16/FP32高精度向量计算。在这些创新设计的加持下,其 NPU 硬件并行度被充分解锁,计算利用率高达98.7%;相比行业其他旗舰产品,内存带宽消耗大幅下降80%,整体能效提升了100%。
除了强大的 NPU 表现外,X7Ultra 还在国内首发量产了 Armv9车规级 CPU,带来了20% 的性能提升与10% 的能效提升。此外,通过升级的大集群架构,芯片显著增强了多核协同与 L3访存性能,并集成全新 SVE2向量处理引擎,相比上一代 NEON 拥有更强大的 DSP(数字信号处理)性能。
编辑整理:阅读要点
- 功能和价格可能随版本或地区变化,使用前应查看最新说明。
- 安装软件或启用服务时,优先使用项目官方渠道并检查所需权限。
- 是否适合长期使用,应结合自身设备、工作流和实际体验判断。
延伸阅读
资料来源:news.aibase.com。本文依据公开资料整理,不是独立采访或独家报道。